查询工作原理
查询文件与查询块如何展示 Zotero 文库的实时视图,以及 ZotLit Query 如何读取文献、文件与标记。
查询文件在 Obsidian 中展示 Zotero 文库的实时筛选视图。查询块则在单篇笔记内展示同类视图。
在写作时,你可以利用它们随时查看一组标注。例如,汇总学位论文所有文献中带有 figure 标签的高亮,或者将某个分类中的文献以表格形式列出。
查询文件与查询块
查询文件是扩展名为 .zotquery 的仓库文件。它交互式地实时展示 Zotero 文库中的条目、文件或标注。如果你熟悉 Obsidian Bases(.base),查询文件采用了类似的结构和工具栏控件,但它是直接查询你的 Zotero 文库。你可以在标签页中打开它,也可以将其嵌入任何笔记中:
![[Figures.zotquery]]
![[Figures.zotquery#Yellow highlights]]
第二行展示该文件中指定的已命名视图。若不指定视图名称,嵌入内容将显示第一个视图,即默认视图。
查询块是笔记中语言为 zotquery 的代码块。它包含与查询文件相同的文本,因此你可以在使用该视图的笔记中保留一次性的视图:
```zotquery
views:
  - type: annotations
    name: Annotations
    from: annotations
    filters: item == this.item
```
新建的查询文件默认在文献的“表格”视图中打开,因此即使你还没有任何高亮,它也能展示有用的内容。它的第二个视图展示你的标注。
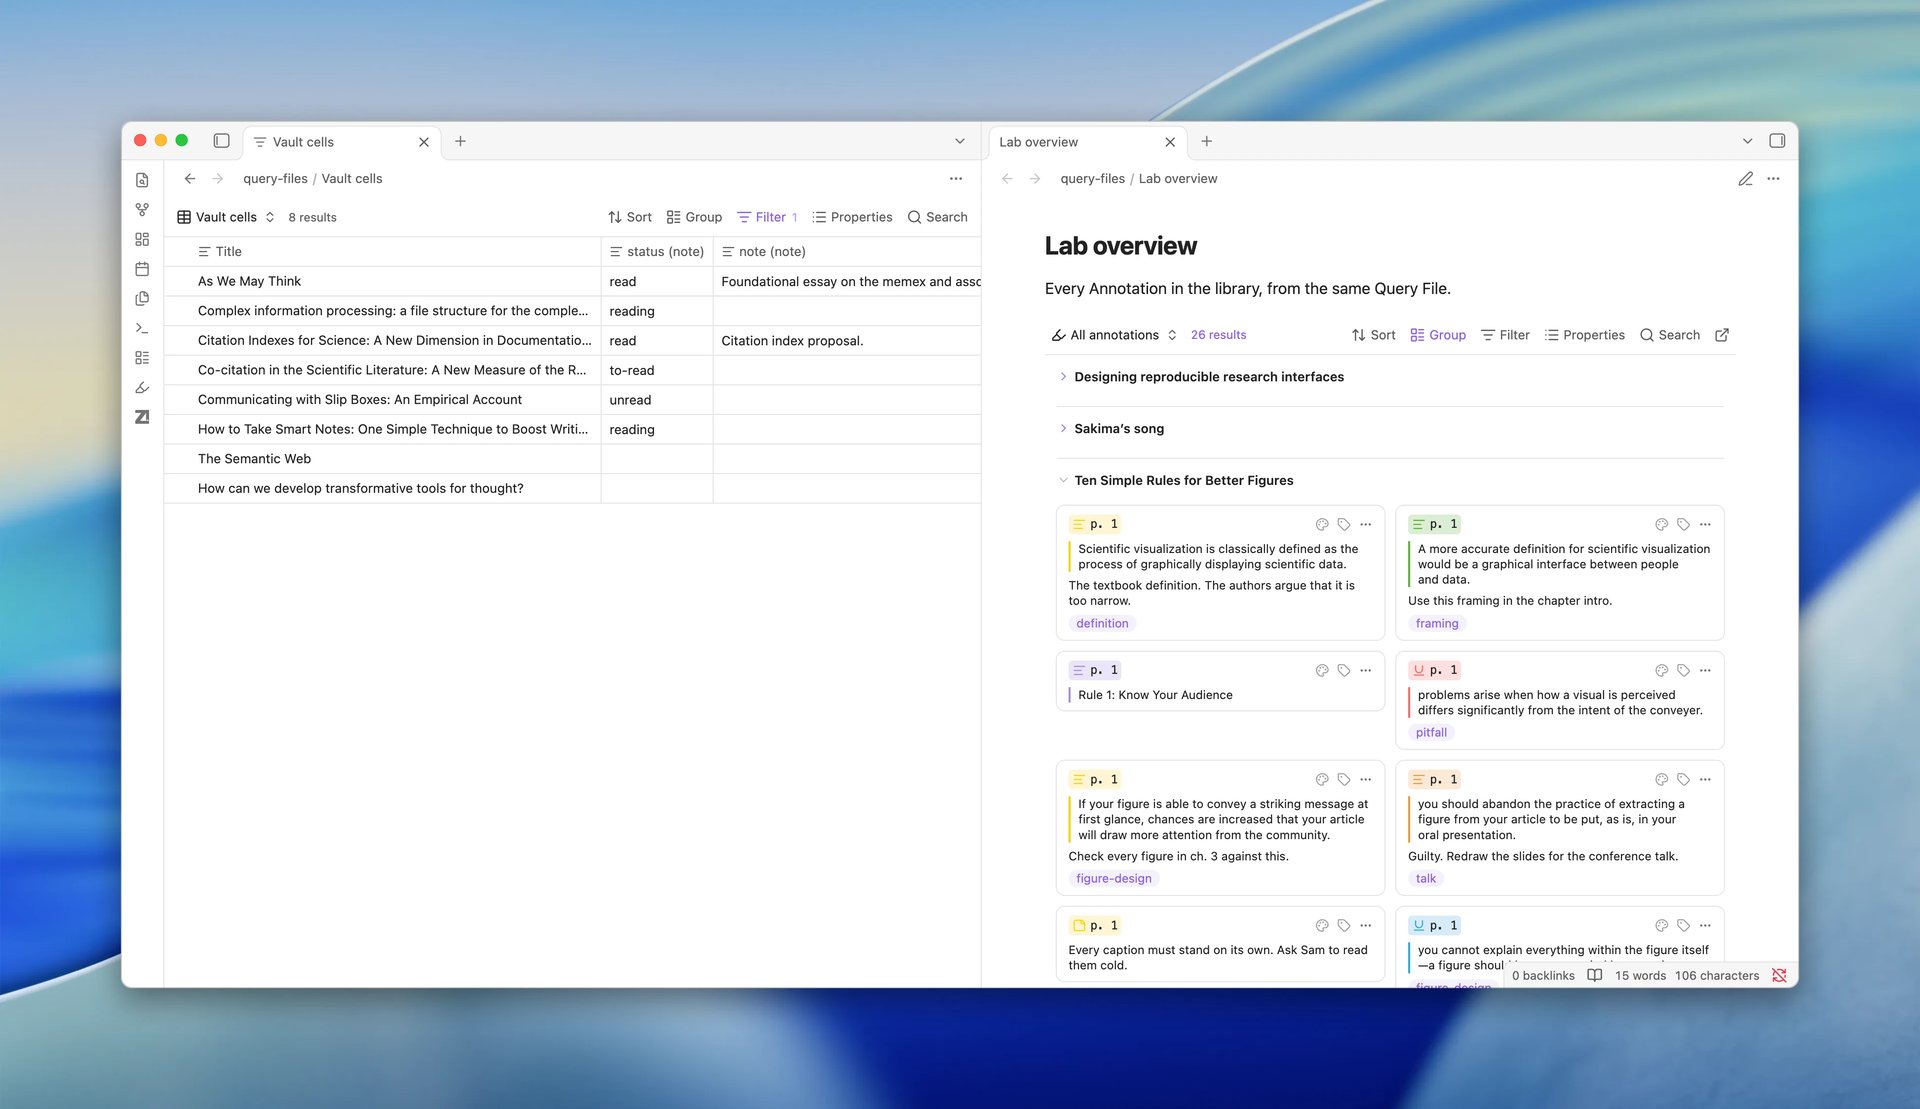
侧边栏的 Zotero 标注 也是同类视图。它展示当前跟随附件的标注。
视图、记录与布局
查询文件或查询块包含一个或多个视图。每个视图都有一个名称和以下组成部分:
| 组成部分 | 决定内容 |
|---|---|
| 行 | 每行展示哪些 Zotero 记录:标注、附件(文件与链接)或条目(文献)。 |
| 布局 | 视图如何渲染各行:标注、表格、列表或卡片。 |
| 筛选器 | 视图展示哪些记录,例如特定颜色、特定标签或某个分类中的文献。 |
| 排序 | 各行的排列顺序。 |
| 分组 | 将相关行归入一个标题下的属性,例如每条标注所属的文献。 |
| 属性 | 每行按顺序显示的值。 |
每种布局展示特定类型的记录:
| 布局 | 行 | 显示内容 |
|---|---|---|
| 标注 | 标注 | 标注卡片,与侧边栏中的卡片一致。你可以在卡片上编辑评论或标签。 |
| 表格 | 条目 | 每篇文献占一行,类似于 Zotero 的条目列表。某一行可以展开显示其文件、标注和笔记。附件标题和标注文本是可点击的链接,能直接打开来源 PDF。 |
| 列表 | 标注、附件或条目 | 每条记录占一行,显示其属性。 |
| 卡片 | 标注、附件或条目 | 每条记录显示为一张卡片。第一个属性为卡片标题。 |
筛选器分为两种。所有视图的筛选器适用于该文件中与首个视图读取相同记录的所有视图。此视图的筛选器仅适用于当前视图。如果所有视图共享某个规则(例如限制在同一个分类中),可将其放入所有视图的筛选器中。
更改保存在视图所在的位置
每个视图都有一个工具栏。工具栏中的更改(如新的排序方式)会立即保存:
- 在查询文件标签页或嵌入位置中,更改会保存到查询文件中。该文件的所有标签页和嵌入视图都会立即体现此更改。
- 在查询块中,更改会重写笔记中的代码块文本。即使该代码块是通过分节嵌入或悬停弹出框显示的,更改也会保存到包含该代码块的笔记中。
- 在侧边栏中,更改保留在侧边栏内。
导出为 PDF 或打印的笔记会展示当时的各行内容,但不包含工具栏。在无法保存视图更改的地方(例如笔记预览中),视图仍会展示其各行内容,并在工具栏下方显示 此处的更改不会保存。打开笔记以更改此视图。
this:笔记对应的文献
筛选器可以将展示该视图的笔记所对应的文献指定为 this.item。这使得同一个查询文件可在多篇文献笔记中复用:每篇笔记仅展示自身文献的标注。
 Literature Note "Smith 2020"          Literature Note "Lee 2023"
 zotero-key: SMITH20                   zotero-key: LEE23
        │                                     │
        ▼                                     ▼
 ![[Paper annotations.zotquery]]       ![[Paper annotations.zotquery]]
 filters: item == this.item            filters: item == this.item
        │                                     │
        ▼                                     ▼
 annotations of Smith 2020             annotations of Lee 2023
this 的含义取决于视图显示的位置:
| 视图显示位置 | this.item | this.attachment |
|---|---|---|
| 笔记中的嵌入视图或查询块 | 笔记 zotero-key 属性指定的条目 | 无值 |
| 侧边栏标注视图 | 侧边栏当前跟随的条目 | 侧边栏当前跟随的附件 |
| 独立标签页中的查询文件 | 无值 | 无值 |
当文献所在的文库超出你的 文库范围 设置时,视图将不显示任何行,并提示 此条目的文库不在文库范围内,因此视图无法显示它。请在 ZotLit 设置中将该文库加入文库范围。 其他查询警告也会以相同方式显示在各行上方。
若筛选器在 this 没有值的地方读取了它,查询将无法运行。此时视图会显示 此视图无法显示结果。 及失败原因。视图还会显示建议,说明应在何处打开它,例如将视图嵌入文献笔记或在侧边栏中打开 PDF。
文献笔记中的标注
默认文献笔记模板会在笔记的 Annotations 标题下放置一个查询块,而在较早版本中此处则是将标注列为文本。该代码块展示笔记自身文献的标注,并与 Zotero 保持同步。
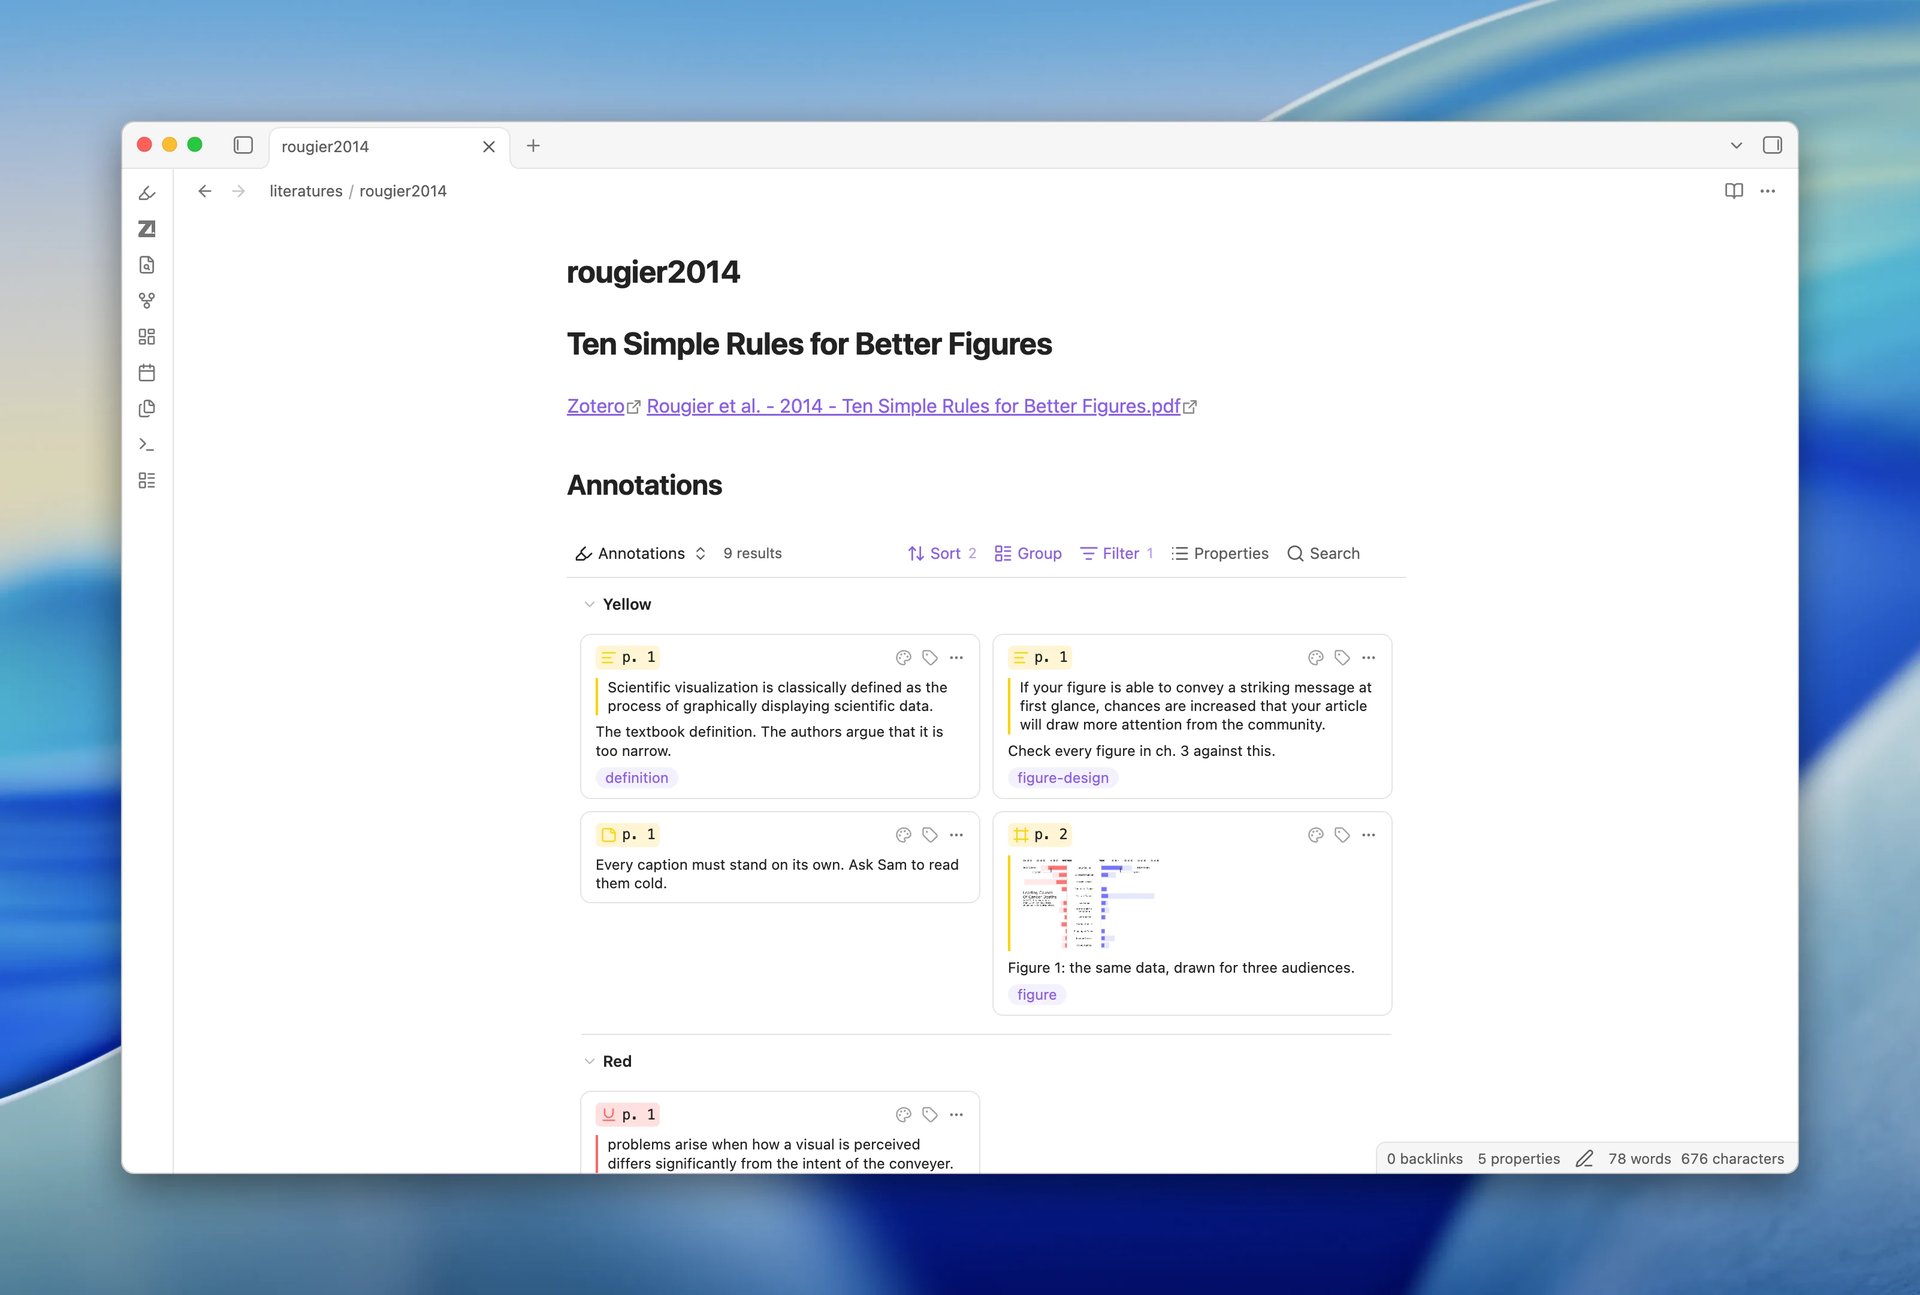
当 ZotLit 更新笔记时,会保留笔记中的代码块文本,因此你在代码块工具栏中做出的更改不会丢失。使用早期默认模板创建且仍保留托管区域的文献笔记,在下次更新时会获得此代码块。自定义模板则保持原样不变。
Zotero 回收站中的文献在此代码块中不显示任何标注。默认模板展示了该模板,并介绍了如何改为将标注列为文本。
来自文献笔记的属性
条目视图可以在文献的 Zotero 字段旁展示其文献笔记的属性,例如你在笔记上维护的 reading-status 属性。视图将它们称为仓库属性,并命名为 vault.<name>。
这些值存储在你的笔记中,而非 Zotero。Obsidian 的属性面板(Properties panel)和 Bases 会读取相同的值。对于 Zotero 共享群组文库中的文献,你的属性值仅保存在本地仓库中,不会同步给其他成员。尚未创建文献笔记的文献目前没有存储属性值的地方,因此在表格中对其进行的第一次编辑会自动创建其笔记。
ZotLit Query 只读取 Zotero 数据库,绝不读取你的笔记,因此 ZotLit 会自行解析仓库属性。视图是在 ZotLit Query 内部应用 limit 的,因此在查询运行前,ZotLit 会预先规划基于仓库属性的排序或筛选:
- 排序会先读取最多 5,000 篇匹配的文献,对其排序,然后保留其中的
limit条。 - 筛选会根据笔记中的属性值转换为一份文献列表,ZotLit Query 将这份列表连同其余筛选条件一起读取。
在这两种情况下,limit 统计的都是你所看到的行数。这也是为什么仓库属性条件必须作为独立条目置于筛选器的顶层 and 之下。ADR 0070 记录了这一设计。
在查询视图中跟踪阅读状态介绍了具体步骤。仓库属性列出了相关规则。
实时更新与读取
当 Zotero 发生更改,或者你修改了 文库范围 设置时,视图都会自动刷新。视图读取的是 Zotero 数据库,因此即使 Zotero 关闭,它也能继续展示各行内容。在标注卡片上进行的编辑则需等待 Zotero 启动。
当筛选器出现错误时,视图会保持上次显示的行,并显示 筛选条件有错误。视图显示上一次的结果。 出错的条件会在筛选器编辑器中显示具体原因。
Obsidian CLI 中的 ZotLit Query
ZotLit Query 可通过 Obsidian CLI 解答关于 Zotero 文库的查询。你或为你工作的智能体只需运行一条命令 zotlit:query,即可获得 JSON 格式的返回结果。
三类记录
Zotero 文库中包含三类对研究问题至关重要的记录。ZotLit Query 将每类记录称为一个查询数据集(Query Dataset),通过 from 来选择:
from | 单条记录是 | 示例 |
|---|---|---|
items | 文献、图书或其他作品 | 期刊文章、学位论文、网页 |
attachments | 归属于它的文件或链接 | PDF、EPUB、保存的网页快照 |
annotations | 你在该文件中添加的标记 | 高亮、笔记、图片、手绘 |
from=items 是默认值。独立文件和回收站中的记录不属于这三个数据集中的任何一个。
各个数据集之间存在双向关联:
          attachments ──►              annotations ──►
  Paper ─────────────────────  File ─────────────────────  Mark
 (items)    ◄── item         (attachments)  ◄── attachment  (annotations)

  Paper ── annotations ──► every mark on all of its files
  Mark  ── item ─────────► the paper that the mark belongs to
文献在 attachments 中列出其文件,并在 annotations 中列出其所有标记。文件在 item 中指明其所属文献,并在 annotations 中列出其标记。标记在 attachment 中指明其所属文件,并在 item 中指明其所属文献。这些列表(如文献的 attachments)被称为关联列表(Relation Lists)。
文献还在 notes 中列出其 Zotero 子笔记,包含每条笔记的标题与日期。笔记不是独立的数据集:你只能从文献中访问它们。例如,!notes.isEmpty() 可以查找包含子笔记的文献。
由于关联是双向的,请根据你要计数的记录来选择数据集:
- “哪些文献没有 PDF?”统计的是文献:从
items开始,查看每篇文献的文件。 - “哪些链接文件丢失了?”统计的是文件:从
attachments开始。 - “显示某篇文献上的所有高亮”列出的是标记:从
annotations开始,按所属文献进行筛选。
查询的执行步骤
每个查询都按以下顺序经历相同的阶段:
 Target Libraries ──► filter ──► sort ──► limit ──► fields ──► rows
 (where to look)    (which      (order)  (how     (which
records) many) values)library指定查询读取的目标文库:personal代表“我的文库”,group:<groupID>代表群组文库,也可以是文库列表或all。如果不指定library,则读取 文库范围 设置中的文库。filter是筛选条件,例如tags.contains("to-read")。当记录满足条件为真时,就会加入结果中。条件可以深入关联列表进行检查,例如检查每篇文献的文件。sort对记录进行排序,例如-date表示最新优先。limit设置返回记录的最大数量。默认值为 100,limit=all则返回所有匹配项。结果中的truncated: true表示还有更多匹配记录。fields指定每行返回的值,例如title,date.year。带有[]的路径会从列表的每个元素中读取一个值:attachments[].path会返回文献每个文件的存储路径。
缺失值与错误值
筛选器或公式在处理记录时可能会遇到两类缺失情况。ZotLit Query 将它们严格区分开来:
 number(volume)

 volume: "12"       ──►  12
 volume: (empty)    ──►  null                      missing data
 volume: "Spring"   ──►  { "kind": "error",        an Error Value
                           "code": "unparseable-text",
                           "message": "number() cannot read \"Spring\" as a number." }
null 表示记录在该处没有数据。缺失字段会返回 null,对 null 进行计算同样返回 null,例如对没有日期的文献计算 date.year + 1。传入 number()、date() 或 duration() 的空文本同样返回 null,超出列表末尾的索引也是如此。
错误值(Error Value)表示尽管数据存在,但表达式无法为该记录计算出结果。以下情况会产生错误值:
- 非空但
number()、date()或duration()无法解析的文本 - 两种不同类型之间的比较(如数字与文本之间使用
<) - 运算中类型不正确的值,例如在混合了文本和数字的列表中
- 结果不是有限数值,例如除以零
- 参数超出范围,或索引不是整数
- 超出日期范围的日期运算
在查询结果行中,错误值具有 kind: "error"、稳定的 code 和 message。查询视图会在单元格中显示警告图标,并在工具提示中显示该信息。复制和 CSV 导出时会写入 Error: 及该信息。
筛选器如何处理错误值
错误值会穿透所有运算符、方法和函数,因此包含错误值的更大表达式的结果依然是同一个错误。在筛选器需要判断真或假时,错误值均视为假:
- 筛选器绝不会因为错误值而选中某条记录。
- 当
x为 null 或错误值时,!x为真。 - 错误值不等于任何值(包括其自身),因此
!=为真。 - 对错误值调用
isType("error")为真。例如,number(volume).isType("error")可以选出卷号不是有效数字的文献。
在每条记录上都会失败的错误(例如 title * 2),会在读取任何记录之前中止整个查询。返回的结果将是指出该错误的一条失败信息。
this:相对于单篇文献的查询
筛选器可以将某篇文献或某个文件指定为 this.item 或 this.attachment。该文献或文件被称为查询上下文(Query Context):查询本身并不指明它,而是由调用方提供。
 zotlit:query from=annotations filter='item == this.item' this-item=ABCD2345
                                       └──────┬──────┘    └───────┬───────┘
                                    the same filter       the paper that
                                    for every paper       this.item means
在命令行中,通过 this-item 和 this-attachment 来提供上下文。在 Obsidian 中,查询文件或查询块直接从展示它的笔记中获取上下文,因此同一个筛选条件即可展示每篇文献笔记各自文献的标记。
如果筛选器在缺少上下文的情况下读取了 this,则无法运行。返回的结果将是指出缺失值的失败信息。
分组如何统计记录
group 根据某个值将匹配的记录分入各组并统计每组数量。按出版年份统计文献的查询会为每个年份生成一个分组。每个分组都有其 value、count 以及最多达到 limit 数量的前几行记录。totalCount 则是所有匹配记录的总数。
文献只有一个年份,但可以有多个标签。使用 [](如 group='tags[].name')时,文献会为其拥有的每个标签各加入一个对应的分组:
 Paper A  tags: methods, review  ──►  group "methods"  ◄──  Paper B  tags: methods
                                 ──►  group "review"
 Paper C  no tags                ──►  group null

 groups: methods 2, review 1, null 1      totalCount: 3
文献 A 在两个分组中都被统计,因此各分组数量相加会大于 totalCount。没有标签的文献会加入 null 分组。相同的规则也适用于分类(collections[])和文件类型(attachments[].fileType)。
精确名称优先
筛选条件中的分类路径和标签名称必须与 Zotero 完全一致,包括大小写。分类路径从顶层分类开始,层级之间用 / 连接,例如 Query thesis/Chapter 1。
zotlit:query-values 可以列出确切名称,因此查询可分两步执行:
 "my thesis collection"
          │
          ▼
 zotlit:query-values kind=collections match=thesis
          │   returns: "Query thesis", "Query thesis/Chapter 1"
          ▼
 zotlit:query filter='collections.within("Query thesis")'
当筛选条件指定的分类路径在任何目标文库中都不存在时,查询仍会执行,只是没有任何记录与该路径匹配。返回结果会附带一条 unknown-collection 警告,并给出最接近的现有路径。如果其他文库中包含该路径,警告中还会建议包含它的 library 参数值。
智能体、指南与架构
zotlit-query 智能体技能指导 AI 智能体如何将研究问题转换为这些查询命令。该技能包含了研究工作流。在构建查询之前,智能体会从 ZotLit 的两个实时信息源读取详细信息:
zotlit:query-guide会输出当前运行的 ZotLit 版本的指南。它通过经过测试的示例解释了筛选器、字段、排序、分组、结果以及取消操作。zotlit:query-schema列出了每个数据集的所有字段、文库的自定义字段以及默认值。
由于智能体每次启动时都会读取这两个信息源,因此其生成的查询始终与仓库中安装的 ZotLit 版本保持一致。
另请参阅
最后更新于